首页
产品与服务
行业解决方案
Growth研究院
尘锋动态
了解尘锋
登录
GPT-6和上一代AI有一个很明显的区别,它更会检查:现在手里的信息,到底够不够把当前任务做完。
比如你让AI做一个任务:
"帮我分析一下为什么2026年企业开始重新算AI的账。找一些真实案例和数据,最后做成一份给老板看的5页PPT。"
上一代模型很容易出现一个问题:只要资料已经够生成一份PPT了,它就开始做。第一轮搜索找到模型降价、Token成本、几家厂商强调推理效率、一些"企业关注AI ROI"的报道——已经够填满5页,它就结束搜索开始生成了。
但这些信息只够把PPT做完,不够把PPT做好。
"AI越来越便宜"和"企业为什么开始重新算AI的账"中间还差了一截。
还缺的信息可能包括:企业AI预算有没有变化?哪些公司开始换小模型、压缩调用次数?哪些AI项目因为ROI不够被暂停?
GPT-6会更容易在这里停一下:我已经有很多资料了,但它们真的够回答用户的问题吗?
这一步很小,但它会直接改变后面的工作。
以前AI很容易出现一种特别麻烦的情况:看起来把任务做完了,但只是完成了外壳,内里还不够扎实。
五页PPT做得整整齐齐,标题、数据、结论一个不少,真正拿到会上却经不起追问:
“这个案例能说明企业普遍开始控成本吗?”
“你说企业更看ROI,依据是什么?”
“这是企业自己的变化,还是AI厂商在换营销话术?”
人最后还是得回去替AI补这些漏洞,凭借自己的经验、能力和品味,替AI修修补补。
GPT-6开始改善的,就是这个过程,它开始更能交付一份可以直接使用的结果了。
为什么?
一部分来自reasoning能力的继续强化。
模型不只是想着“下一步写什么”,还会更频繁地检查:这份任务最终要解决什么、现在的证据支持到了哪一步、哪个结论还不能下、还需要补什么信息。
另一部分来自OpenAI这次明确强调的professional environments训练。
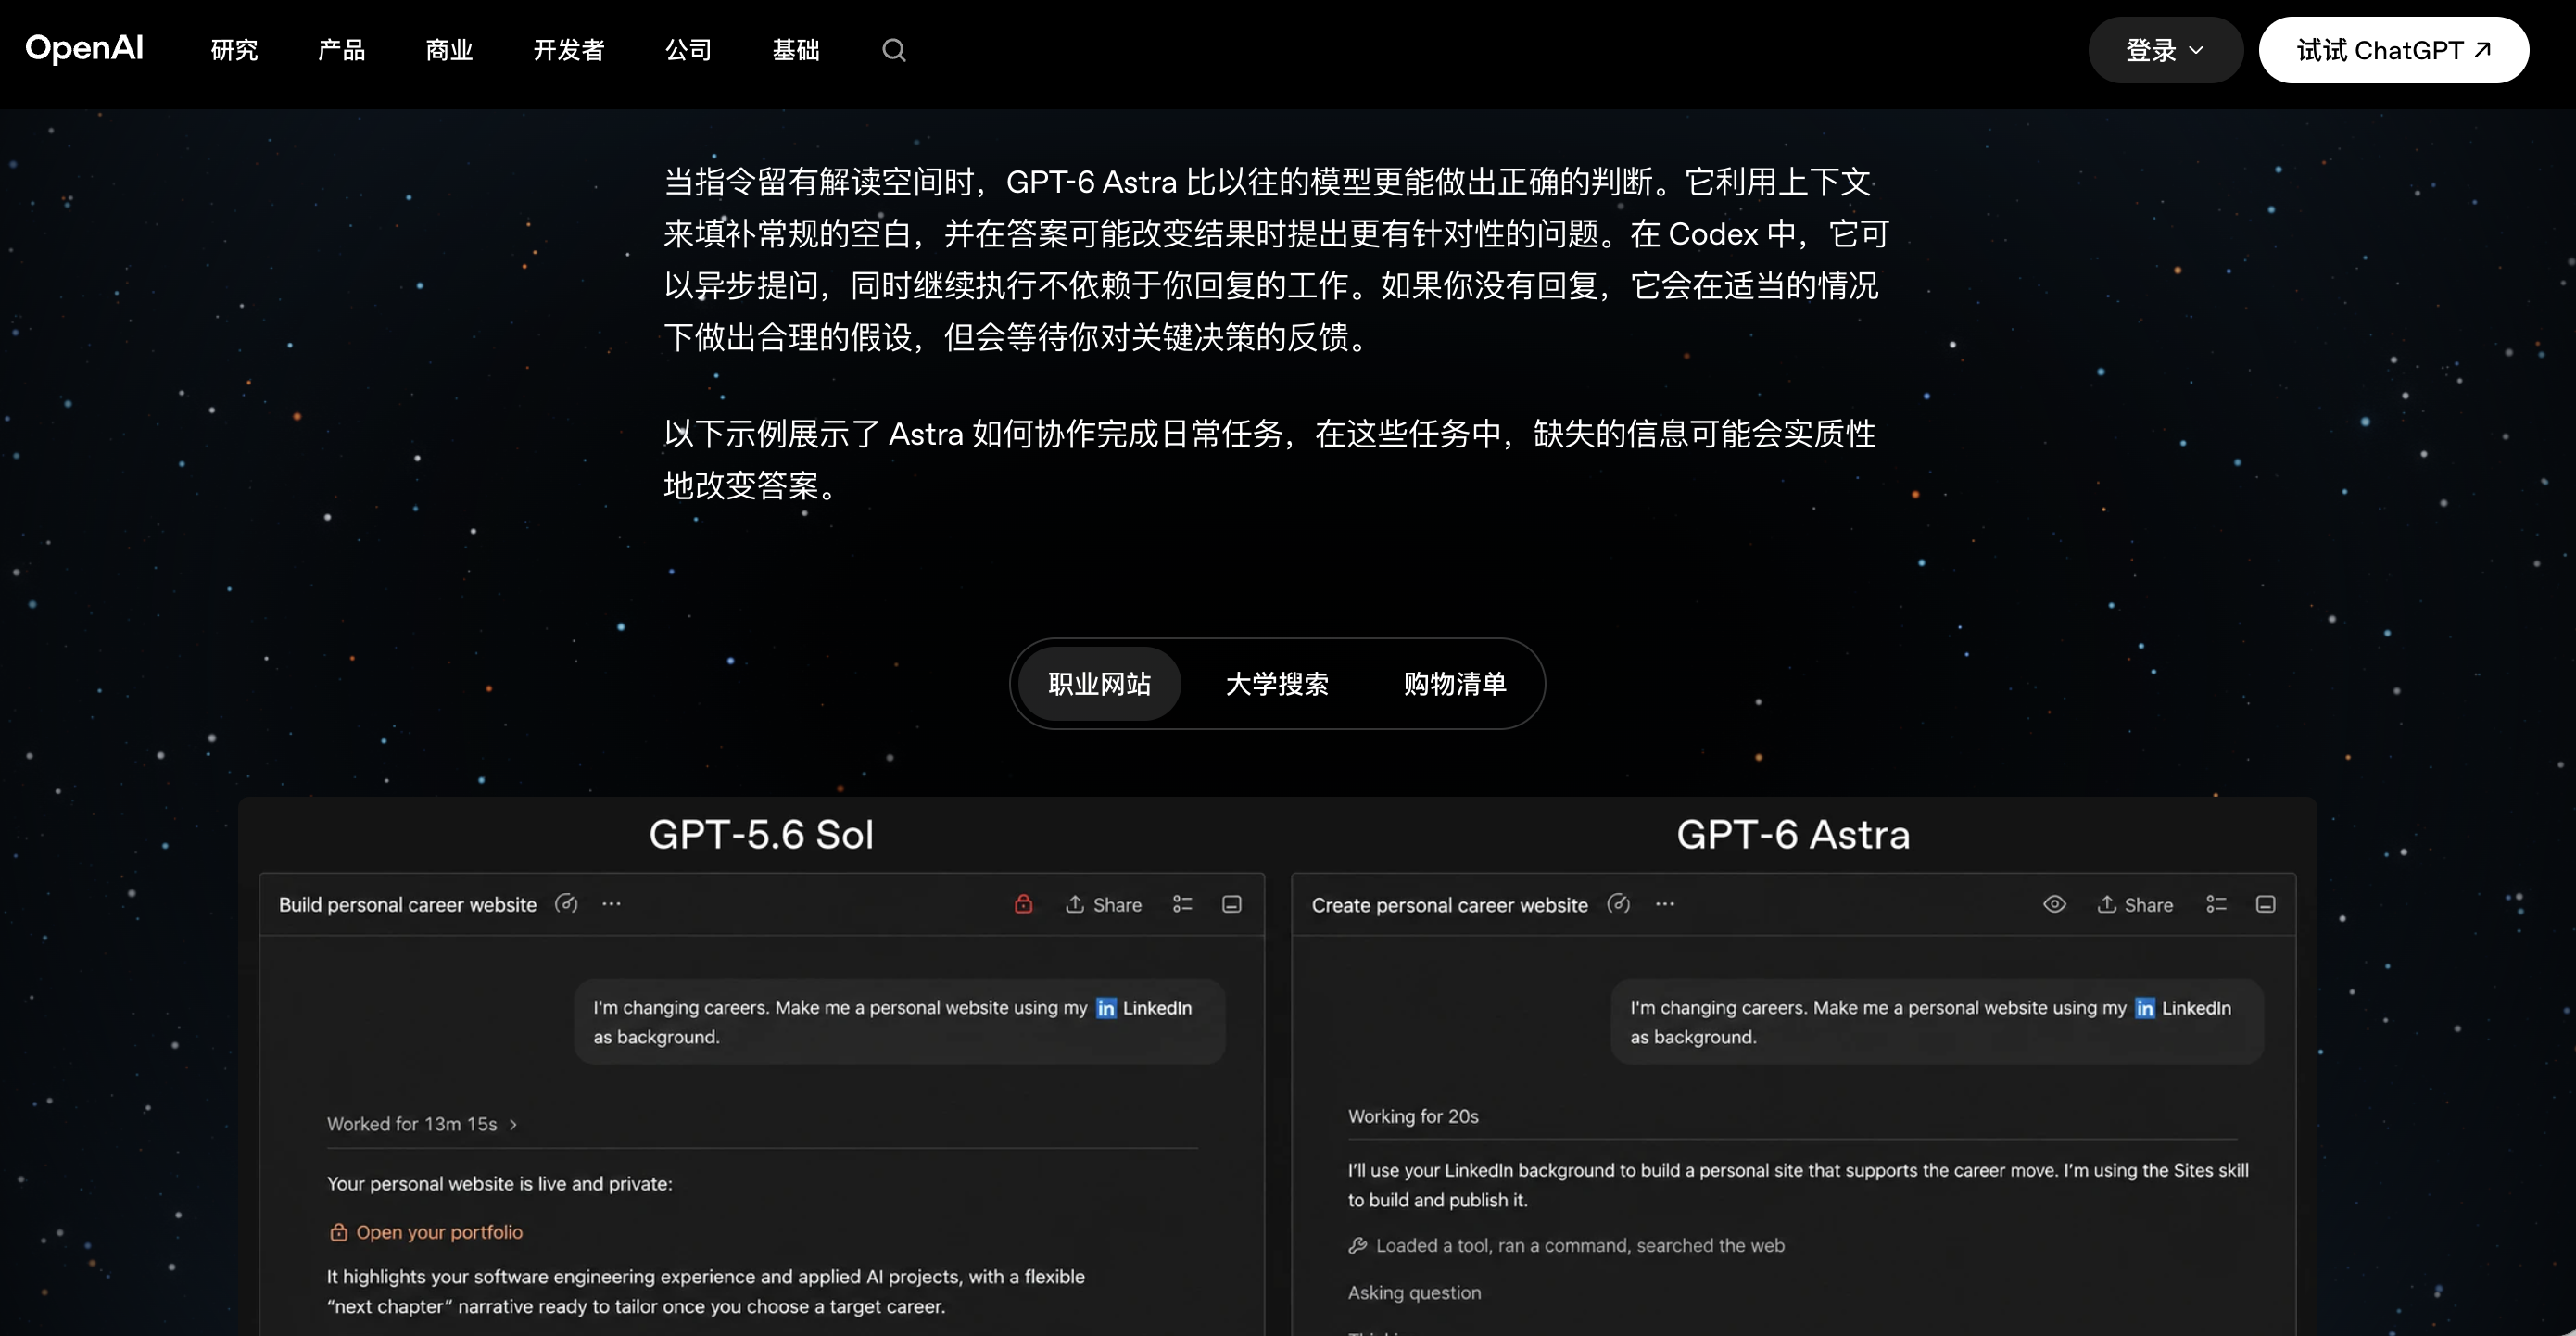
因为一份真的要交给老板看的PPT的标准,和“生成5页关于AI成本的内容”完全不是一回事。
后者只要有看起来说得通的内容,前者必须回答一个完整的问题,而且里面的细节、判断、论证都要站得住,才算真的做完了任务。
当模型被越来越多地按照“这份工作能不能真的交出去”训练,它就必须学会在资料已经够写的时候,继续检查资料到底够不够用。
这项变化真正有价值的地方也在这里。过去把这样一个任务交给AI,人往往还得在旁边不停补: “再找几个真实企业。” “论述错了,前后不构成直接关系” “这个只能说明模型降价,不能说明企业在控成本。” “别只找厂商自己说的。” “这个结论证据不够。”
过去,AI负责搜和写,人负责盯着它有没有漏东西。
现在,GPT-6开始自己承担其中一部分判断,交付可用的结果,也更能够节约人的时间和精力。
坦白说,以前用AI做任务其实已经很好用了。
让它改一段文案、总结一篇文章、分析一张表,任务只有几步,它能够帮人提高很多效率。
AI不好用的情况,通常出现在多轮对话、长任务的场景里。
比如你把30份客户访谈、一份产品资料、过去两个季度的销售数据都扔给AI,让它分析客户流失的主要原因,最后整理成一份管理层汇报。
做到前几步通常都没问题,它会读材料、整理问题、做分类。
但任务越往后走,上一代模型越容易出现一种很熟悉的情况:它没有完全忘,但记得越来越模糊,特别容易做着做着就跑偏了。
最开始明明要求重点分析“为什么已经付费的客户不续费”,做到后面,大量篇幅却花在了“客户对产品有哪些意见”。
如果不在过程中重复任务原本的目标,直接任凭它发散着做到最后,你会发现结果根本不是你要的,粗略看起来是一回事,实际细看千差万别。
GPT-6这一代改善的,是这种长任务里的目标漂移。
它更有能力在做到很后面的时候,重新把最开始的任务要求拿回来检查:
我现在分析的还是“为什么客户不续费”吗?
这个结论和前面已经确认的信息冲突吗?
用户最开始要求重点关注的那几个条件,我是不是还满足?
这也是为什么GPT-6的长上下文提升,不能只理解成“它能一次塞进100多万Token”。
上一代模型处理特别长的任务时,经常需要把前面的内容做compaction,简单理解就是把已经发生过的事情压缩成一份摘要,然后带着摘要继续往后干。
问题也很明显:摘要是缩略的,一定会丢东西。
几十轮工作里,一个很小但很重要的限制,一次已经验证失败的尝试,一条用户很早之前说过的要求,都可能在不断压缩以后变得模糊。
GPT-6这一代开始把工作记忆做得更像我们真正工作的方式。
OpenAI这次在Codex里给Astra增加了一套新的长任务记忆机制:它可以跨上下文窗口保留notes,需要的时候重新搜索更早的对话和工具结果。
人其实也是这么工作的。
没有人能把一个做了三个月的项目从头到尾全部记在脑子里。我们靠会议纪要、项目文档、聊天记录、自己的工作笔记,需要的时候再回去翻。
GPT-6开始拥有类似的能力了。
三、做到一半改需求,不需要从头再来
过去用AI做任务,如果中间改变了主意,经常需要重新开一个窗口从头来过。
比如你让AI做一份全球市场分析,做到一半补了一句:"海外先不要了,这次只看国内。"
上一代Agent处理不好这条新要求和原任务之间的关系。
要么把"只看国内"当成全新任务,原来的分析维度全丢了;要么判断原计划不适用了,从头来过,前面已经完成的有效工作也跟着被推翻。
而你真正想要的没那么复杂:把海外数据删掉,留下的资料继续用,按原来的维度接着做。
GPT-6改善的就是这种判断能力:需求变了以后,什么需要改,什么不用改。 Mid-turn steering让它在任务执行中途可以被追加修改并判断:新要求到底改了什么?前面的哪些工作还能继续用?哪些部分需要重做?
过去模型更像在执行一段已经写好的指令,而真实工作不是一段指令,它会在过程中经常变化,有灵光一闪,也有悬崖勒马。
GPT-6开始更有能力维护这种不断变化的任务状态,跟上你的临时变化。
以前AI,更多是当一个参谋,而不是做事的士兵。
比如你让它:“把CRM里过去一个月没跟进的客户筛出来,按意向度重新分类,再把名单整理进Excel。”
过去模型可以告诉你完整的步骤,但是不擅长把这个事给做了。
Agent经常会卡在特别琐碎的地方:按钮在哪?哪个下拉框要点?页面弹窗遮住了什么?字段错了?Excel里该把数据填在哪一列?
这些在人看来根本不算“智力”的事情,恰恰是AI过去很容易掉链子的地方。
GPT-6这次一个很明显的变化,是它看电脑界面、理解界面、再执行操作的能力明显提高了。
ScreenSpot-Pro就是专门测试这件事的。
它会给AI一个真实的软件界面,再告诉它要完成什么任务,看它能不能准确找到应该操作的位置。
GPT-5.6 Sol的测试结果是76.9%,GPT-6 Astra到了92.7%。
这个提升看起来只是一个跑分,但对应到真实工作里非常具体:以前AI可能知道“下一步要点筛选”,现在它更有可能真的找到那个筛选按钮。
再往后是OSWorld,这个测试更接近真正“坐在电脑前干活”,要求AI在操作系统和软件环境里连续完成任务。
GPT-6 Astra在OSWorld 2.0里做到72.6%,GPT-5.6 Sol是65.7%。
更值得注意的是,同样一类任务,Astra模拟平均用时大约40分钟,5.6 Sol约75分钟。
可以说,现在AI开始把过去分开的两件事接起来:理解任务 + 操作软件。
以前你问AI怎么做Excel,它可以教你。
现在它越来越能直接进去改Excel。以前你让AI分析CRM数据,它可能先让你把数据导出来给它。现在它越来越有能力自己进CRM找。
以前AI更多活在聊天框里,现在它开始真正进入人每天工作的那些软件。
这也是为什么Computer Use这次很重要。
因为企业里的大量工作,并没有现成的API,也没有专门为AI重做一套系统。
它们就是网页、后台、Excel、CRM、ERP、各种已经用了很多年的软件。
如果AI只能调用专门接好的接口,那每进入一个系统,都要先有人给它“修路”。
Computer Use走的是另一条路:人能怎么操作,AI就尽量学会怎么操作。
当然,现在72.6%的OSWorld成绩也说明它远没有到“随便把电脑交给它”的程度。复杂任务里仍然会出错,高风险操作也需要权限和人工确认。
但这个进化方向已经很清楚:GPT-6开始学习把鼠标接过去,直接替你做了。
另外,在AI能直接操作电脑之后,权限边界也变得更重要。OpenAI这次也同步强化了Astra对任务授权范围的遵守——能力越强,“能做什么”和“允许做什么”必须一起升级。
五、GPT-6具备了更强的并行任务处理能力
过去Agent处理复杂任务,很多时候还是串行的。
比如让AI做一份客户背景调查,它可能需要查CRM里的客户历史、搜索这家公司最近的公开新闻、读取之前的会议纪要,最后再把这些信息整合起来。
这三件事其实互相并不依赖,可以并行去做,但上一代Agent更容易按照一条线往前走:
先查CRM,等结果回来;再搜索新闻,继续等;再读取会议纪要。
每一步都能自己完成,但只能一件一件做完了再往前推进。
GPT-6开始改变的是这一点:彼此独立的任务,可以同时往前跑。
也就是说,以前更像:A做完 → B做完 → C做完 → 汇总
现在可以变成:A、B、C同时启动 → 等结果陆续返回 → 汇总
背后对应的是GPT-6支持的Async Tool Calling。
过去模型调用一个工具之后,通常需要等这个工具返回结果,才能继续下一步。现在一个工具还在执行,模型可以先处理其他不依赖这个结果的任务。
所以这项提升并不是“某个工具调用得更快了”。
真正变化的是:AI开始更会安排多个任务之间的先后关系。
哪些事情必须等前一步完成,哪些事情完全可以同时做,它开始能分得更清楚。
六、不止学模板,还能学规矩了
企业里的真实工作,有很多模板可复用:PPT有公司模板,方案有过去材料,销售分析有现成格式,回复客户有公司的表达习惯。
真正让AI进入工作流,比起生成通用资料,我们更需要它生成符合企业标准的结果。
过去的AI经常做得很表面。给它一份管理层汇报让它照着做下一季度,它能模仿颜色、标题、页面结构。
但真正的"按照同样方式做"远不只是长得像——为什么第一页先放结论?为什么有些数据进正文有些只放附件?为什么同样是下降10%,这个标红那个轻描淡写?这里面是团队已经形成的工作习惯和判断标准。
GPT-6明确强化了professional environments训练,面对现有材料时,不只是模仿表面样子,而是可以延续这家公司已有的表达方式、结构和交付标准。
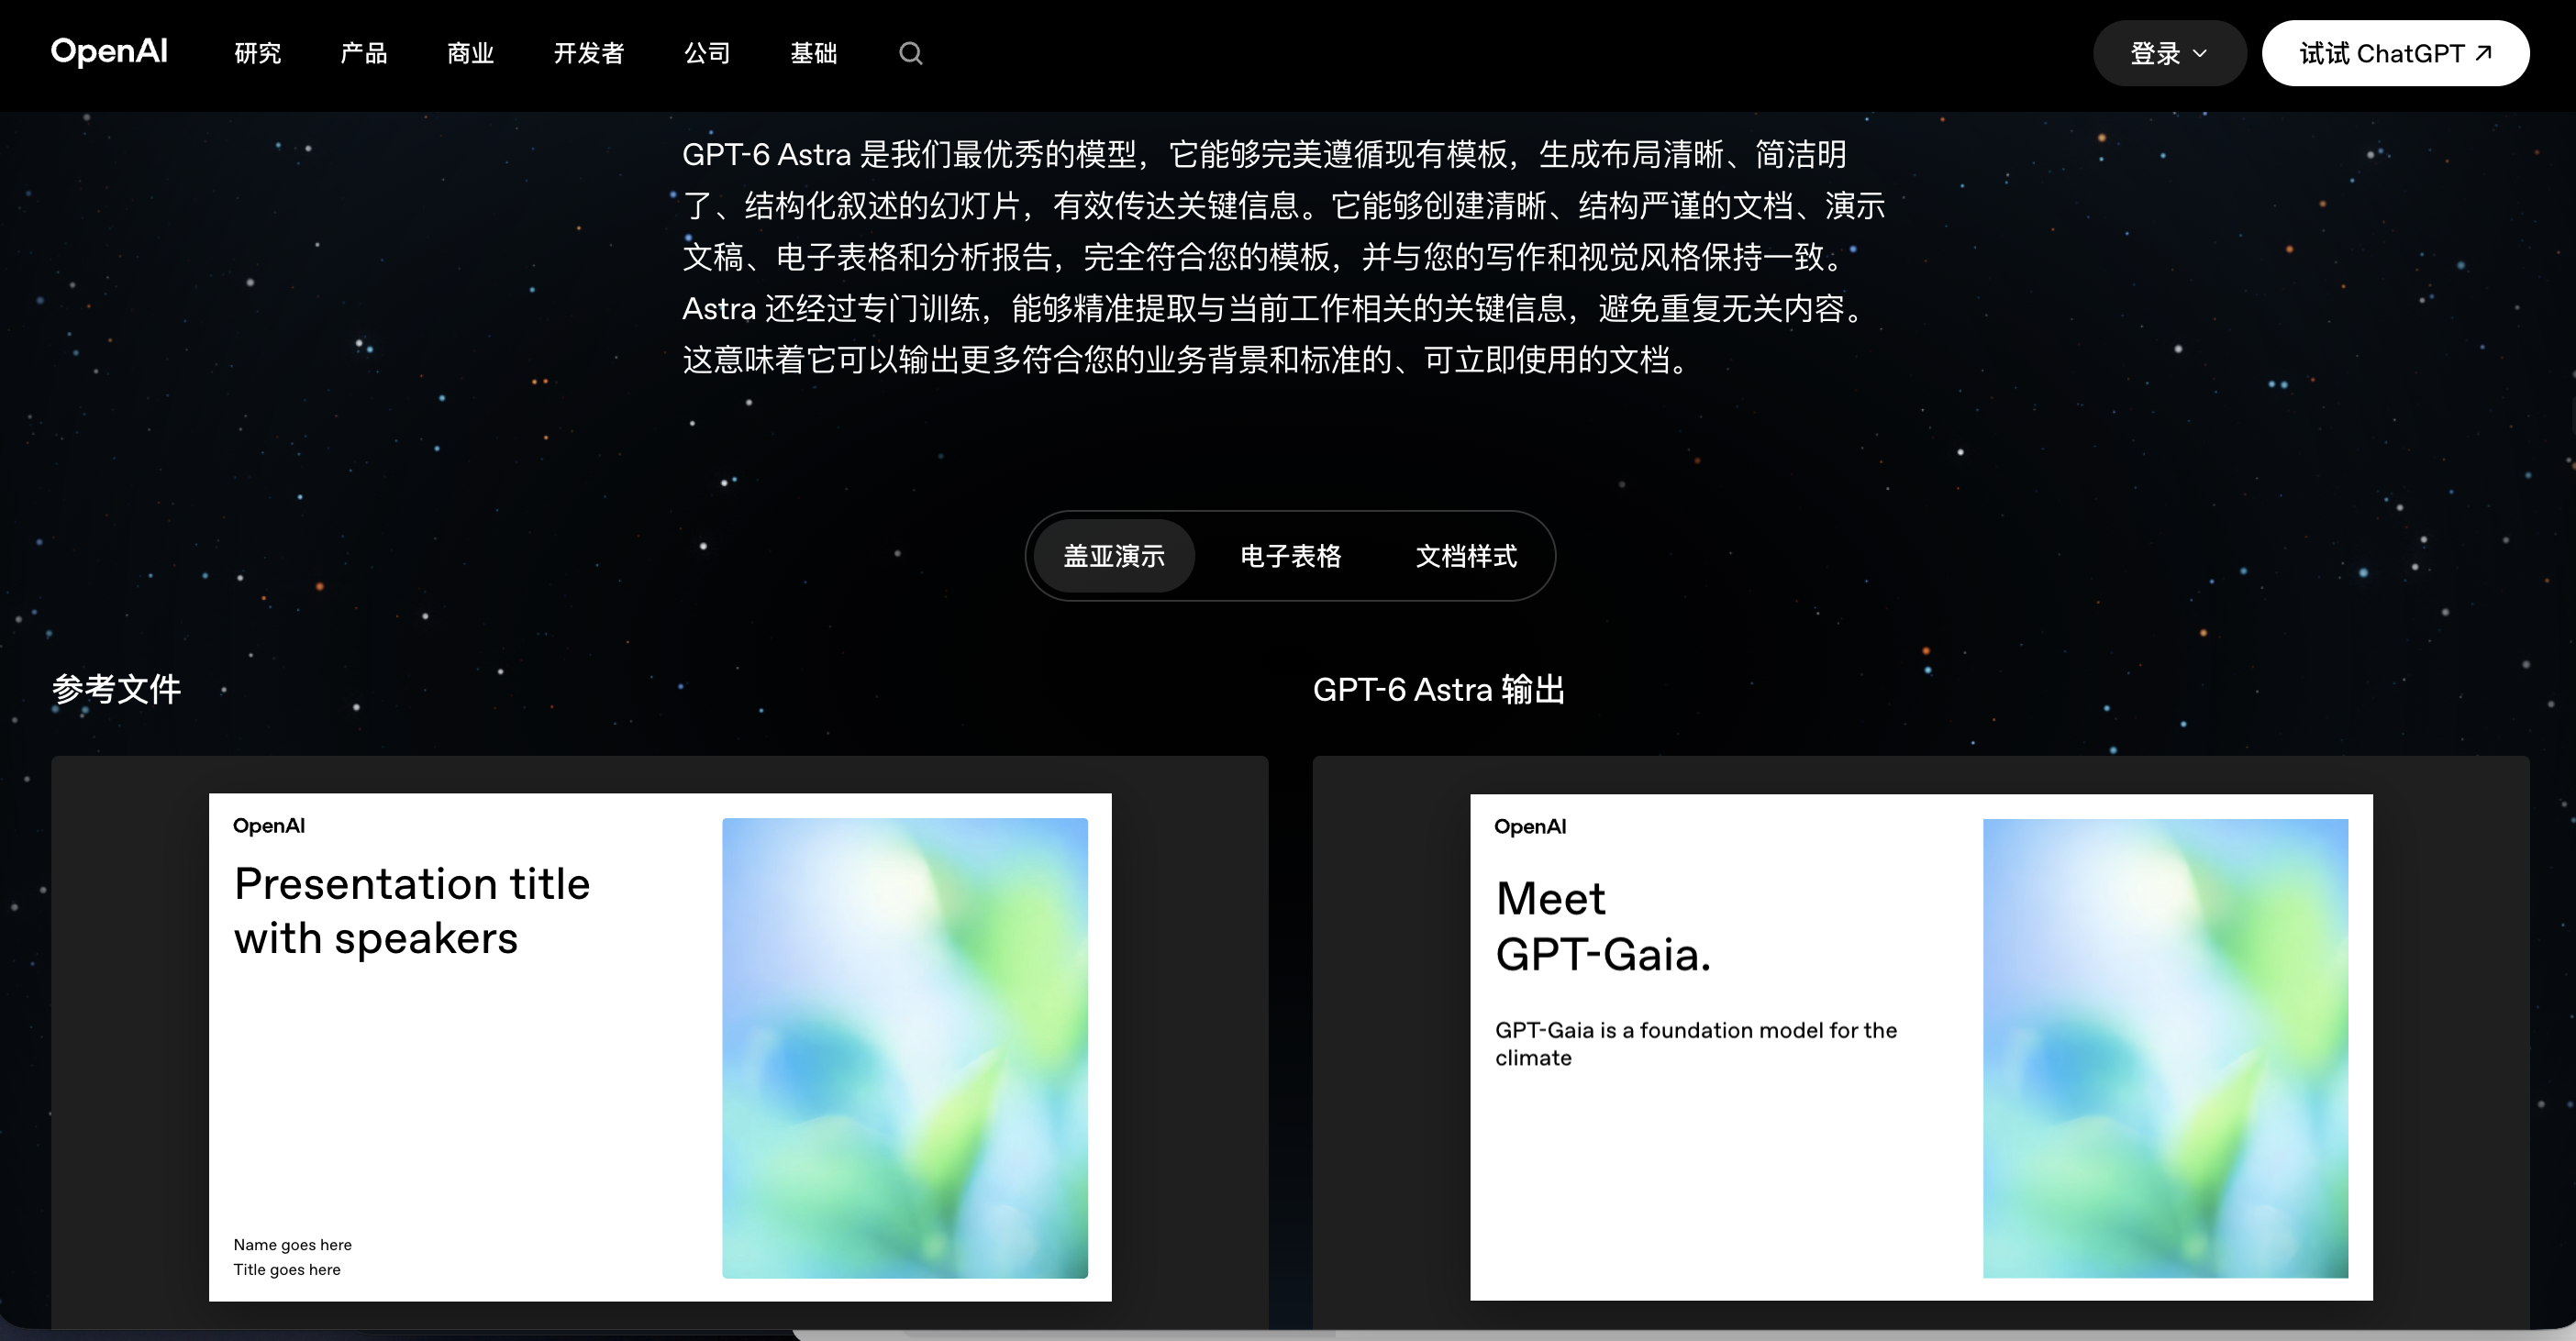
过去和AI协作,真正消耗人的往往不是"从零写五页PPT",而是把AI生成的东西一点点改成公司的样子。
这个转换成本,正在被减少。现在你把一份过去的分析报告甩给GPT-6,它给你的会更接近“拿来就能用”。
七、GPT-6强在,可以直接完成工作了。
同样是做一份PPT,GPT-5.6也能做,GPT-6也能做。真正的差别发生在中间。
资料不够的时候,它能不能自己发现?
任务做到后面,还能不能记得最开始的要求?
中途需求变了,是不是必须从头来?
面对公司已有的材料,它到底在另做一套,还是能接着用?
这些变化单独拿出来,都不像"模型突然聪明十倍"那么刺激。但合在一起,改变的是人和AI之间的协作方式。
过去用AI,人得一直站在旁边:告诉它哪里漏了,提醒它前面说过什么,需求变了重新解释一遍,最后再把结果改成公司能用的版本。AI在做动作,人在补判断。
GPT-6这一代,开始把那些"人替AI操心"的部分,一点点接了过去。
如果用一句话总结GPT-6强在哪,可以说,AI正在从"需要你盯着干活的实习生",变成"能独立交付的专业员工"。
点击注册体验ChatDoing
一句话生成企业级AI客服